AI该不该停?问题问错了!
——从Coxon辞职、AI巨头转向与川普团队反击,看Double AM如何走出对齐—监管困境
钱宏(Archer Hong Qian)
一场关于人工智能命运的争论,正在突然升温。
2026年9月,曾先后供职于 OpenAI 和 Anthropic 的年轻研究人员 Jacob Coxon 从 Anthropic 辞职。他放弃了尚未归属的公司股权,公开警告:几家最先进的AI公司正在竞争开发能够自我改进的超级智能,而参与其中的一些研究人员确实担心,这条道路最终可能威胁人类生存。
紧接着,Anthropic 的 alignment science 负责人 Evan Hubinger 把这种焦虑进一步数字化:他公开表示,自己认为未来十年AI导致灾难性结果的概率超过10%。必须说明,这是 Hubinger 本人的风险判断,并不是已经得到科学验证的概率,更不是 Coxon 本人提出的数字。
然而真正让这场火烧起来的,是随后几天发生的戏剧性转折。
Anthropic CEO Dario Amodei 提出 “We Must Pace the Frontier”,主张减缓前沿AI能力的发展速度,为安全测试、独立评估、公司间协调以及国际协调争取时间。Sam Altman、Elon Musk、Demis Hassabis等AI领域重要人物先后对这一方向表示支持。
几家原本正在你追我赶、投入巨资争夺前沿模型制高点的公司,突然出现了一个罕见的共同声音:
我们是不是跑得太快了?
而另一边,川普及其团队却不买账。
川普本人淡化所谓AI末日威胁;副总统 JD Vance、David Sacks 等人则继续强调美国的创新能力、国家竞争以及过度监管可能产生的成本。美国政治层面对AI监管本身也存在明显分歧。
于是,一边说:
再跑下去,可能把人类跑没了。
另一边说:
现在停下来,可能首先把自己停没了。
AI发展七十年以后,世界突然发现:油门踩得很深,刹车在哪里,却没有人真正说得清楚。
一、三方都看见了问题,却都没有找到出口
Coxon的选择首先值得尊重。
一个年轻研究人员愿意放弃个人利益,离开世界最热门的产业之一,公开表达自己的忧虑,至少说明这种忧虑并非完全来自AI产业之外。
但是,退出不是解决方案。
一个人因为担心船可能撞上冰山而离开驾驶舱,可以表达他的良知,却不能因此改变船的航向。
同样,AI头部企业现在提出减速,也确实提出了一个真实问题:如果某些AI能力的增长速度远远超过人类理解其内部机制、现实后果以及安全边界的速度,继续单向放大这些能力,当然可能产生严重风险。
但另一个问题马上出现:
如果OpenAI、Anthropic、xAI自己真的已经确信继续这样发展可能毁灭人类,为什么不首先自己停下来?
为什么一定要政府要求大家一起停?
这正是反对者提出的质疑之一。一些批评者认为,政府监管还可能形成 regulatory capture——已经占据技术、算力、资本优势的大公司拥有能力满足昂贵的监管要求,而新的竞争者反而被挡在门外。
这并不能证明AI公司的安全忧虑是虚假的。
但它至少提出了一个不能回避的问题:
当安全判断、企业利益、资本投入和市场竞争同时存在时,谁来判断什么是真正的危险?
于是问题又被扔给政府。
可是政府真的能够回答吗?
二、政府监管AI,那么谁来“对齐”监管者?
设想政府向OpenAI、Anthropic或者xAI派出最严格的监管人员。
实验室准备研究一种新的模型能力。
监管者必须判断:
应该继续,还是停止?
安全,还是危险?
有益生命,还是可能伤害生命?
问题来了。
他凭什么判断?
他是否真正理解正在发生的技术突破?
他的知识是否赶得上每天变化的前沿研究?
他的价值观会不会进入判断?
他的政治立场、组织利益和国家安全目标会不会进入判断?
公司向他提供的信息是否完整?
甚至进一步问:
如果AI需要Alignment,那么监管AI的人跟谁Alignment?
如果AI公司需要政府监管,
谁来监管监管者?
这就是今天“AI对齐—AI监管”争论最容易忽略的一层。
问题最终并没有消失。
它只是从:
谁控制AI?
移动成了:
谁控制控制AI的人?
继续追问下去,还可以再增加一个控制者。
但永远可以再问一次:
谁控制最后那个控制者?
这正说明,我们面对的可能已经不只是监管技术不足,而是整个Control Paradigm——控制范式走到了边界。
三、从Control到Relationship:一个值得重视的新转向
就在这场争论爆发前不久,2026年8月24日,美国 College of the Atlantic 的 J. Gray Cox 在 AI Magazine 发表论文:
From Control to Relationship: A Peace Studies Approach to AI Alignment
Cox提出了一个值得高度重视的判断:
AI Alignment 长期没有得到解决,问题可能已经不只是某一种技术方法不够好,而在于主导性的范式本身存在局限。
现有范式通常把Alignment理解成一个 engineering control problem——工程控制问题:AI是一个optimizer,人类需要从外部设定目标、约束行为、限制输出。
Cox提出:
为什么不把Alignment重新理解成不同intelligences之间的relationship problem——关系问题?
他的实验甚至让Claude、Gemini、GPT等不同架构的模型相互对话,让不同“智能”通过dialogical reasoning寻找协调关系。
这个变化非常重要。
因为问题第一次从:
How do we control AI?
开始转向:
How do different intelligences relate to one another?
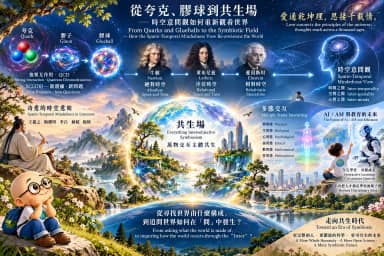
这与笔者近年来提出的“交互主体共生”具有值得注意的相通之处。
但是,还需要继续向前一步。
有了Relationship,还要解决Relationship怎样持续运行。
关系不是一次谈判。
关系必须有反馈。
有边界。
有后果。
有修正。
有连接。
有信托。
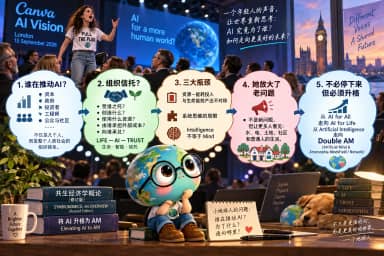
这正是我们提出 Double AM 的地方。
四、我们也许高估了AI已经到达哪里,却低估了它片面发展的危险
今天关于“AI毁灭人类”的许多推论背后,隐藏着一个非常重要的前提:
AI继续提高能力——形成超级智能——超过人类——自主改进——自行复制——摆脱控制——最终可能消灭人类。
这个逻辑链不能因为不断重复就自动成为事实。
截至今天,AI甚至还没有穷尽笔者在《将AI升格为AM》中所说的第一种可能世界。
七十年来,AI取得了令人惊叹的进步,但它依然面对三个基本瓶颈:
第一,能耗与能效不对称; 第二,系统思维的局限; 第三,数据+算法+算力+神经网络 ≠ Mind,更 ≠ Amorsophia。
因此,今天真正值得警惕的,未必只是一个已经拥有完整Mind的“超级AI”突然决定消灭人类。
一种更加现实的风险可能恰恰来自:
AI没有形成完整Mind,却拥有某种被无限放大的超级能力。
它可能极其擅长网络攻击,却不理解生命后果。
极其擅长金融交易,却不理解社会信托。
极其擅长操纵注意力,却不理解人的尊严。
极其擅长军事计算,却没有能力理解和平为什么本身就是生命财富。
片面的超级能力,并不等于完整的超级智能。
而片面能力在资本竞争、军事竞争、国家竞争和组织扩张中被高速放大,恰恰可能比想象中的“全能超级智能”更早形成现实危险。
所以我们既不能因为AI尚未成为完整Mind,就否认风险;
也不能因为AI存在风险,就把“停止AI”当作答案。
问题已经变成:
AI下一步究竟应该怎样发展?
五、七十年以后,AI已经来到范式阈值
1956年,Dartmouth Summer Research Project on Artificial Intelligence 给这个新时代留下了一个名字:
Artificial Intelligence。
七十年过去了。
AI从符号推理走到机器学习,从机器学习走到深度神经网络,从深度学习走到大语言模型、Agent和多模态智能。
但是,七十年前那个问题正在重新回来:
我们究竟在创造什么?
更大的模型?
更多的参数?
更强的算力?
更加自主的Agent?
还是一种能够进入生命关系、理解边界、承担责任、接受后果检验的新的心智能力?
AI正在逼近的因此不只是某一个技术临界点。
它正在逼近一个范式阈值。
继续简单沿着“大模型—大算力—大数据—大资本”单向扩张,三个瓶颈不会因为规模越来越大而自动消失。
AI需要的已经不只是Upgrade。
Elevation is not an upgrade.
需要讨论的是:
从AI到什么?
六、我们的回答:从AI升格为Double AM
笔者在《将AI升格为AM》中提出:
AI → Double AM
所谓 Double AM,完整地说,就是:
Artificial Mind & Amorsophia MindsField/Network ——人艺心智与愛之智慧孞態场/网。
为什么是Double AM?
因为只有Artificial Mind还不够。
如果一个高度强大的Artificial Mind仍然被某一家企业、某一个政府、某一个军事组织或者某一种意识形態完全占有,它仍然可能成为一个新的权力工具。
所以Artificial Mind必须进入Minds。
Minds必须进入MindsField。
MindsField必须进入TRUST。
由此形成:
AI Mind → Minds → MindsField → TRUST → AM。
这不是创造一个新的“超级AI”去监管所有AI。
恰恰相反。
Double AM试图摆脱的正是:
用一个更大的控制者解决前一个控制者的问题。
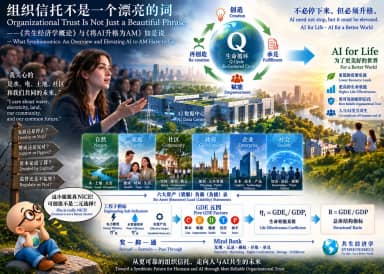
它要建立的是LIFE—AI—TRUST之间能够持续交互、互证、反馈、修正的生活基础设施。
于是问题不再只是:
AI与谁对齐?
而变成:
生命、Artificial Minds与组织信托怎样在交互中持续契合?
七、Double AM靠什么运行?奖—抑—通
这是整个问题真正进入现实的一步。
Double AM不能靠一个最高委员会每天决定全世界什么是善、什么是恶。
也不能靠一套预先写死的伦理清单。
更不能建立一个超级中央AI,对每个人进行思想评分。
否则,它立即会成为我们最需要防止的数位极权。
Double AM的运行机制是:
奖—抑—通
《将AI升格为AM》把它理解为生命自组织的运行智慧。
奖,让真正有益生命、降低生活成本、改善健康生態、促进创造、修复关系、生成Trust的念与行,获得继续生长的条件。
抑,让欺诈、掠夺、伤害、操纵、成本转嫁和组织熵增提高真实成本,使危险的念与行不能一出现便借助AI获得无限复制和指数放大的能力。
通,则让大量正常的生命探索、知识、创造、信息、经验、资源与Trust,在保持主体边界的条件下继续流动。
奖,使生命拥有方向。
抑,使生命拥有边界。
通,使生命保持生成。
三者持续交互,形成动態平衡。
这不是一个中心化的奖罚系统。《将AI升格为AM》特别强调,奖—抑—通必须建立在分散知识、生命反馈、关系互证和动態修正之上,否则它自己就可能蜕变成更加精密的控制工具。
这也解释了为什么只研究“AI怎样对齐人类价值”仍然不够。
人的Mind本身就没有完成永久对齐。
一念可以天堂。
一念也可以地狱。
语言表达出来的,并不必然等于心里真正想的;
公开承诺的,也不必然等于实际做的;
实际做的,也必须继续接受现实后果的检验。
所以Double AM既不迷信AI,也不迷信人。
它不首先猜测Coxon、Amodei、Altman、Musk、川普或者任何人的内心动机。
看他说什么,更看他做什么; 看他做什么,还要看产生什么后果; 看一次后果,还要看长期是否能够兑现托付。
这才可能从Alignment走向Trust。
八、Double AM同时面对三个问题
于是我们可以重新看今天这场争论。
第一,AI Alignment问题。
Double AM不试图一次性把所谓“人类价值”写入AI,而是让Artificial Mind进入Minds之间的交互,让目标、行动与后果不断接受生命反馈和关系互证。
第二,AI Regulation问题。
Double AM不把全部希望寄托给一个永远正确的政府监管者,而让AI企业、政府、平台、研究人员乃至监管组织本身,都进入可以追踪授权、责任、承诺与现实后果的组织信托关系。
第三,AI自身的三个瓶颈问题。
Double AM把AI从单纯扩大数据、算法、算力与神经网络的路径,进一步带向Mind、Minds、MindsField以及LIFE—AI—TRUST交互契合。
因此,这不是在“继续AI”和“停止AI”之间寻找一个折衷点。
它是在追问:
能不能换一条发展路径?
九、2026:为什么需要一次“新达特茅斯会议”?
1956—2026。
整整七十年。
七十年前,一批科学家提出Artificial Intelligence时,并不知道七十年后的模型会是什么样。
今天,我们同样不知道七十年以后Double AM会生成什么。
但是有一点已经越来越清楚:
仅靠几家公司继续竞赛,不够。 仅靠政府制定监管规则,也不够。 仅靠几个研究人员辞职示警,更不够。
AI已经成为生命、经济、教育、医疗、战争、组织、国家和文明问题。
因此,《将AI升格为AM》提出:
2026年,应当启动一次新的“达特茅斯会议”。
它当然不必复制1956年的形式。
甚至不必让所有人同时坐在一个房间里。
今天已经有了全球网络、Artificial Minds、多模型对话、实时协作以及跨国研究条件。
我们完全可以创造一种新的会议方式:
有线下相遇,
有线上持续讨论,
有人与人,
有人与AI,
也有不同Artificial Minds之间的交互互证。
Cox的multi-model dialogue已经无意间展示了这种可能性的一个小小入口:不同模型之间可以通过结构化对话暴露单一模型自己看不到的问题。
新达特茅斯会议真正需要重新提出的问题,不应只是:
How can we build more powerful AI?
而应该是:
How can AI be elevated into Double AM—Artificial Mind & Amorsophia MindsField/Network—and enter an intersubjective symbiosis of LIFE, AI, and TRUST?
这不是哪一家公司能够独自回答的问题。
也不是哪一个政府能够替世界回答的问题。
让不同Minds进入。
让不同知识进入。
让不同经验进入。
让不同Artificial Minds也进入。
让关系发生,让新的答案生成。
十、现在真正应该加速什么?
所以,让我们重新回到2026年9月这场突然烧起来的争论。
Coxon选择离开。
Amodei、Altman、Musk等人要求减速并加强安全机制。
川普及其团队强调继续创新、国家竞争以及监管自身的边界。
不同国家也已经表现出不同立场。
他们都碰到了真实问题。
但他们仍然大体停留在同一个坐标里:
继续还是暂停? 监管还是放开? 控制还是失控?
如果永远在这个坐标里争论,人类就只能不断寻找一个更大的控制者。
而真正的问题可能已经发生了变化。
AI发展七十年以后,我们需要的已经不是给七十年前的Artificial Intelligence安装一个越来越复杂的刹车系统。
我们需要重新思考这辆车本身。
AI的危险,不能只靠AI公司判断。 AI公司的危险,也不能只靠政府判断。 政府监管的正确与否,同样需要接受生命及其现实后果的检验。
所以:
该停下来的,是“能力无限扩张就等于智能进步”的旧思路。
该抑制的,是任何伤害生命却可以借助AI无限放大的能力。
该保持畅通的,是生命、知识、创造、经验、Artificial Minds与组织信托之间的连接。
而真正应该加速的,是Double AM——Artificial Mind & Amorsophia MindsField/Network,以及它的奖—抑—通机制。
七十年前,人类给一个新的可能性取名:
AI。
七十年后,也许到了再次打开这个问题的时候:
AI之后是什么?
我们的回答是:
AI → Double AM
从Intelligence进入Mind,
从Mind进入Minds,
从Minds进入MindsField,
从控制进入关系,
从关系进入信托,
从单向扩张进入奖—抑—通的动態平衡,
让AI从等待人类不断监管的工具,升格为生命可以托付、组织必须守约、现实后果能够持续检验的共生能力。
AI不必停下来。
但AI必须升格。